Agent Factory : agents et humains, même équipage
Sommaire
Dans les épisodes précédents : les fondamentaux des coding agents, mes workflows Claude Code au quotidien et une stack LLM self-hosted.
Il est temps de changer d'échelle : un environnement partagé, où l'équipe travaille avec les agents et peut faire confiance à ce qu'ils livrent. Cet article ouvre une série consacrée à cette Agent Factory, dont chaque article approfondira une brique.
Depuis quelques mois, je ne code presque plus sans agent, et je constate la même évolution autour de moi : on écrit moins de code, on pilote davantage d'agents.
Seulement, ce qui fonctionne sur mon laptop ne se transpose pas tel quel à une équipe. Chacun arrive avec ses instructions et ses outils, et les pratiques divergent vite d'un poste à l'autre. Dans une organisation, il ne suffit pas que notre coding agent soit efficace : il faut pouvoir garantir la qualité et la sécurité de ce qui part réellement en production, quelle que soit la personne qui a lancé l'agent.
En parallèle, les agents gagnent en fiabilité, au point qu'on peut envisager de leur confier certains changements de bout en bout, de l'issue jusqu'au merge. Encore faut-il savoir sur quels critères leur faire confiance, et pouvoir le mesurer. C'est tout l'enjeu des software factories.
Cette série décrit l'Agent Factory, ma tentative de réponse à ces questions : une chaîne qui va de l'issue à la PR mergée, construite avec des outils open source cloud native. Elle s'appuie sur cloud-native-ref, ma plateforme de référence, qui fournissait déjà une bonne partie du socle (Crossplane, Cilium, ZITADEL, OpenBao, l'observabilité). J'y ai ajouté une couche dédiée aux agents et la glue nécessaire pour faire tourner la machinerie 😉. L'ensemble est documenté sur airef.ogenki.io, le point d'entrée de tout ce que cette série va décrire.
Ce premier article pose le problème et présente la solution dans ses grandes lignes. Les suivants entreront dans chaque brique, à commencer par Maku. Toutes sont open source, et rien n'oblige à tout reprendre : piochez les idées qui vous parlent, adaptez-les à votre contexte. 🚀
🎯 Objectifs de cet article
- 🏭 Comprendre ce qu'on appelle une software factory, et où se situe celle-ci sur l'échelle de l'autonomie
- 🧩 Explorer ce qu’apporte concrètement la factory, côté développeur et côté organisation
- 🗺️ Découvrir l'architecture d'ensemble : trois dépôts, trois couches, et les briques open source qui les composent
- 🔄 Suivre une tâche de bout en bout, de l'issue à la PR mergée
🏭 Software factory : de quoi parle-t-on ?
Une software factory est une chaîne qui transforme une file de travail (des issues, un backlog) en changements livrés, avec des agents à chaque étape. Les exemples les plus cités viennent de grandes équipes d'ingénierie :
- les Minions de Stripe, qui produisent plus de 1 300 PR par semaine ;
- Honk, chez Spotify, à l'origine de plus de 1 500 PR mergées.
Derrière ces chiffres, trois notions suffisent à décrire n'importe quelle factory :
- 🔁 La boucle : chaque agent observe, agit et vérifie, jusqu'à ce que la tâche soit terminée.
- 🧰 Le harnais (harness) : le cadre autour de la boucle. Où l'agent s'exécute, avec quels outils et quelles permissions, et ce que « terminé » veut dire.
- 🚦 Le gate : une ultime étape de validation, qui décide de ce qui part en production.
🪜 Quelle place pour l'humain ?
Ce qui distingue le plus les factories entre elles, c'est la place qu'elles laissent à l'humain. Dan Shapiro a proposé une échelle calquée sur les niveaux de la conduite autonome. Plus on monte, plus l'humain prend du recul :
| Niveau | Votre rôle | Exemple |
|---|---|---|
| 0 · L'autocomplétion améliorée | Vous écrivez le code, l'IA suggère la suite | L'éditeur complète la boucle que vous venez de commencer |
| 1 · Les tâches ponctuelles | Vous confiez des tâches précises et bornées, le reste ne change pas | « Écris un test unitaire pour cette fonction » |
| 2 · Le binôme | Vous travaillez avec l'IA comme avec un collègue junior, à qui vous laissez le répétitif | Une session Claude Code où vous validez chaque modification |
| 3 · Le manager | L'agent écrit l'essentiel du code, vous relisez chaque diff | Plusieurs agents en parallèle, vous passez de l'un à l'autre pour relire |
| 4 · Le rédacteur de specs | Vous écrivez la spec, relisez le plan, puis revenez vérifier que les tests passent | Une issue rédigée le soir, une PR à relire le lendemain matin |
| 5 · La dark factory | Plus personne ne lit le code : des specs entrent, du logiciel sort | Chez StrongDM, « Code must not be reviewed by humans », et les scénarios de test sont tenus hors du dépôt pour que les agents ne les voient pas |

La dark factory n'est pas la direction que je prends. Quand plus personne ne lit le code, qui comprend encore le système ? La connaissance se dilue, et le jour où quelque chose casse, plus personne ne sait où regarder. Comme avec RunLore, je préfère que les agents fassent le travail et que l'humain garde la main sur la décision déterminante : ce qui part en production. Diriger le bateau plutôt que le regarder dériver. ⛵
Cette factory se situe donc au niveau 4 : j'écris l'issue, les agents cadrent, implémentent, testent et se relisent entre eux, et mon approbation du commit vaut merge. Le niveau 5 n'est accordé qu'aux changements qui remplissent des conditions que nous définissons nous-mêmes, des gates versionnés dans le dépôt, avec un disjoncteur qui rend la main aux humains au premier incident.
🧩 Du laptop à l'équipe : qu'est-ce que ça m'apporte au juste ?
Sur mon laptop, la question de la confiance ne se pose presque pas : je lance l'agent, je le regarde travailler, je relis, je pousse. Je suis le garde-fou. Dès que l'agent travaille pour une équipe, sur un cluster partagé et sans personne devant l'écran, ce garde-fou doit passer dans l'architecture. Un agent autonome, c'est du code non relu qui s'exécute avec des droits.
Ce que la factory apporte en échange n'a pas la même réponse selon qu'on est devant le clavier ou qu'on est responsable de ce qui part en production.
👩💻 Côté développeur
⏱️ Déléguer et passer à autre chose. Une issue bien rédigée suffit, personne ne reste devant l'écran, et la PR qui arrive a déjà été relue par un agent. Le 29 octobre, une alerte RunLore s'est déclenchée à 6 h 28, la PR corrigeant la règle était ouverte à 6 h 33 et mergée, avec mon approbation, à 6 h 47.
🚪 Lancer une tâche depuis là où on est. Un label sur l'issue, un message Slack, la CLI, ou directement depuis notre propre coding agent. Pas de contexte à changer.
🧰 Rien à installer, rien à maintenir. Le harnais, les outils, les accès aux modèles et à GitHub sont fournis par la plateforme. Aucune clé sur notre laptop, aucune configuration à tenir à jour, et le même outillage que nos collègues.
🎛️ Garder la main sans tout relire. La room, le journal partagé de la tâche, montre ce que fait l'agent en direct, on peut l'orienter en cours de route ou l'arrêter d'un label. À l'arrivée, une seule action nous revient : approuver le commit, et c'est mergé.
📝 Un compte rendu qui s'écrit tout seul. Budget, étapes, lien vers la room, qui a mergé : tout est posté sur l'issue au fil de l'eau. Plus de « qu'est-ce que j'avais fait déjà ? » en revenant dessus.
🏢 Côté organisation
Des questions nouvelles se posent quand le code quitte le laptop du développeur, et la factory doit y répondre par des garanties :
| Question | Sur mon laptop | Dans la factory |
|---|---|---|
| 🪪 Qui agit ? | Moi, avec mes propres tokens | Chaque exécution d'agent a sa propre identité, courte, et ses dépenses sont imputées à la personne qui l'a lancée |
| 🌐 Que peut-il joindre ? | Tout Internet | Uniquement les destinations nommées ; le reste ne résout même pas |
| 🚦 Qui décide du merge ? | Moi | Des règles versionnées dans le dépôt, et un humain dès qu'elles ne suffisent pas |
| 📓 Où est la preuve ? | Mon terminal, puis plus rien | Un journal partagé et inaltérable par tâche, où chaque action est attribuée. Un audit, un post-mortem ou l'arrivée d'un nouveau collègue partent de là, même six mois plus tard |
À ces garanties s'ajoute ce qu'on attend d'une plateforme partagée :
🧱 Une qualité et une sécurité qui ne dépendent plus du poste. Junior ou senior, laptop bien ou mal configuré : tout le monde passe par les mêmes rôles d'agents, le même reviewer et le même gate. Les règles s'améliorent au même endroit pour tout le monde.
💸 Un coût connu avant de lancer, et borné. Le budget (modèle, tokens, durée) est affiché au démarrage. Une file plafonne les exécutions simultanées, et un disjoncteur coupe une voie dès qu'elle déraille. La correction d'alerte du 29 octobre a coûté 490 k tokens, et je l'ai su avant de merger.
📈 Une autonomie qui s'étend à notre rythme, par des règles écrites. On démarre au niveau 4, où un humain approuve tout. Quand une famille de changements a fait ses preuves, une règle versionnée lui accorde le merge automatique, et on la lui retire au premier incident. La politique se relit et se discute comme du code.
🤝 Un point d'entrée commun pour tout ce qui veut modifier le dépôt. Humains, mais aussi d'autres agents : une alerte traitée par RunLore peut devenir une issue, donc une tâche, donc une PR, sans qu'un humain ait tapé une ligne, et avec les mêmes contrôles.
🔓 Aucune dépendance à un fournisseur. Chaque brique est open source et remplaçable, le modèle est une ligne de configuration, et les humains gardent la connaissance du système puisqu'ils relisent ce qui part en production.
En toute franchise, j'ai beaucoup testé (37 PR d'agents mergées depuis fin septembre), mais sur des changements plutôt simples, quelques fichiers à chaque fois. C'est là qu'une factory trouve toute son utilité : les changements récurrents et bornés. Pour une grosse feature qui enchaîne beaucoup de tâches, le laptop est probablement encore plus rapide. Je suis curieux de voir jusqu'où ça évoluera.
🗺️ Vue d'ensemble de la solution
L’Agent Factory repose sur trois repo (cloud-native-ref, ai-native-ref et maku), qui ont un périmètre bien défini. La plateforme IA, celle qui porte tout ce qui est propre aux agents, a sa propre documentation : airef.ogenki.io.

La plateforme IA est déployée sur le cluster Kubernetes sous la forme d'un artefact OCI signé, et désactivée par défaut : rien ne s'active sans une décision explicite. Le cluster s'engage, dans un contrat écrit, sur ce qu'il fournit (namespaces, identité, secrets, nœuds gVisor, observabilité).
L'Agent Factory est un ensemble de composants open source qui, assemblés, transforment une issue en PR relue.
Maku (幕, « le rideau » en japonais) en fait partie : c'est le contrôleur, celui qui orchestre les autres, avec une promesse : « Run coding agents on your Kubernetes cluster without trusting them. »
Hormis Maku, chaque brique est un projet open source existant, utilisé pour ce qu'il sait faire :
| Brique | Son rôle dans la factory |
|---|---|
| OpenHands | L'agent lui-même : la boucle et ses outils de développeur |
gVisor et agent-sandbox | La sandbox de chaque exécution, avec un noyau en espace utilisateur |
| Crossplane | Compose, à partir d'une seule ressource, tout ce dont une exécution a besoin |
| Cilium | Le réseau fermé par défaut, ouvert nom par nom |
| agentgateway | La porte de sortie unique : identité, accès aux modèles et aux outils, budgets |
| octo-sts | Des jetons GitHub d'une heure, limités à un dépôt et à un rôle |
| policy-bot | La politique de merge, versionnée dans le dépôt |
| Kueue | Une file d'admission plafonnée, pour qu'une factory qui s'emballe ne remplisse pas le cluster |
| ZITADEL, OpenBao, Flux, VictoriaMetrics | Identité des humains, secrets, GitOps et observabilité, fournis par le cluster hôte |
🔄 Une tâche de bout en bout
Voici le parcours d'une tâche, dans ses grandes lignes :
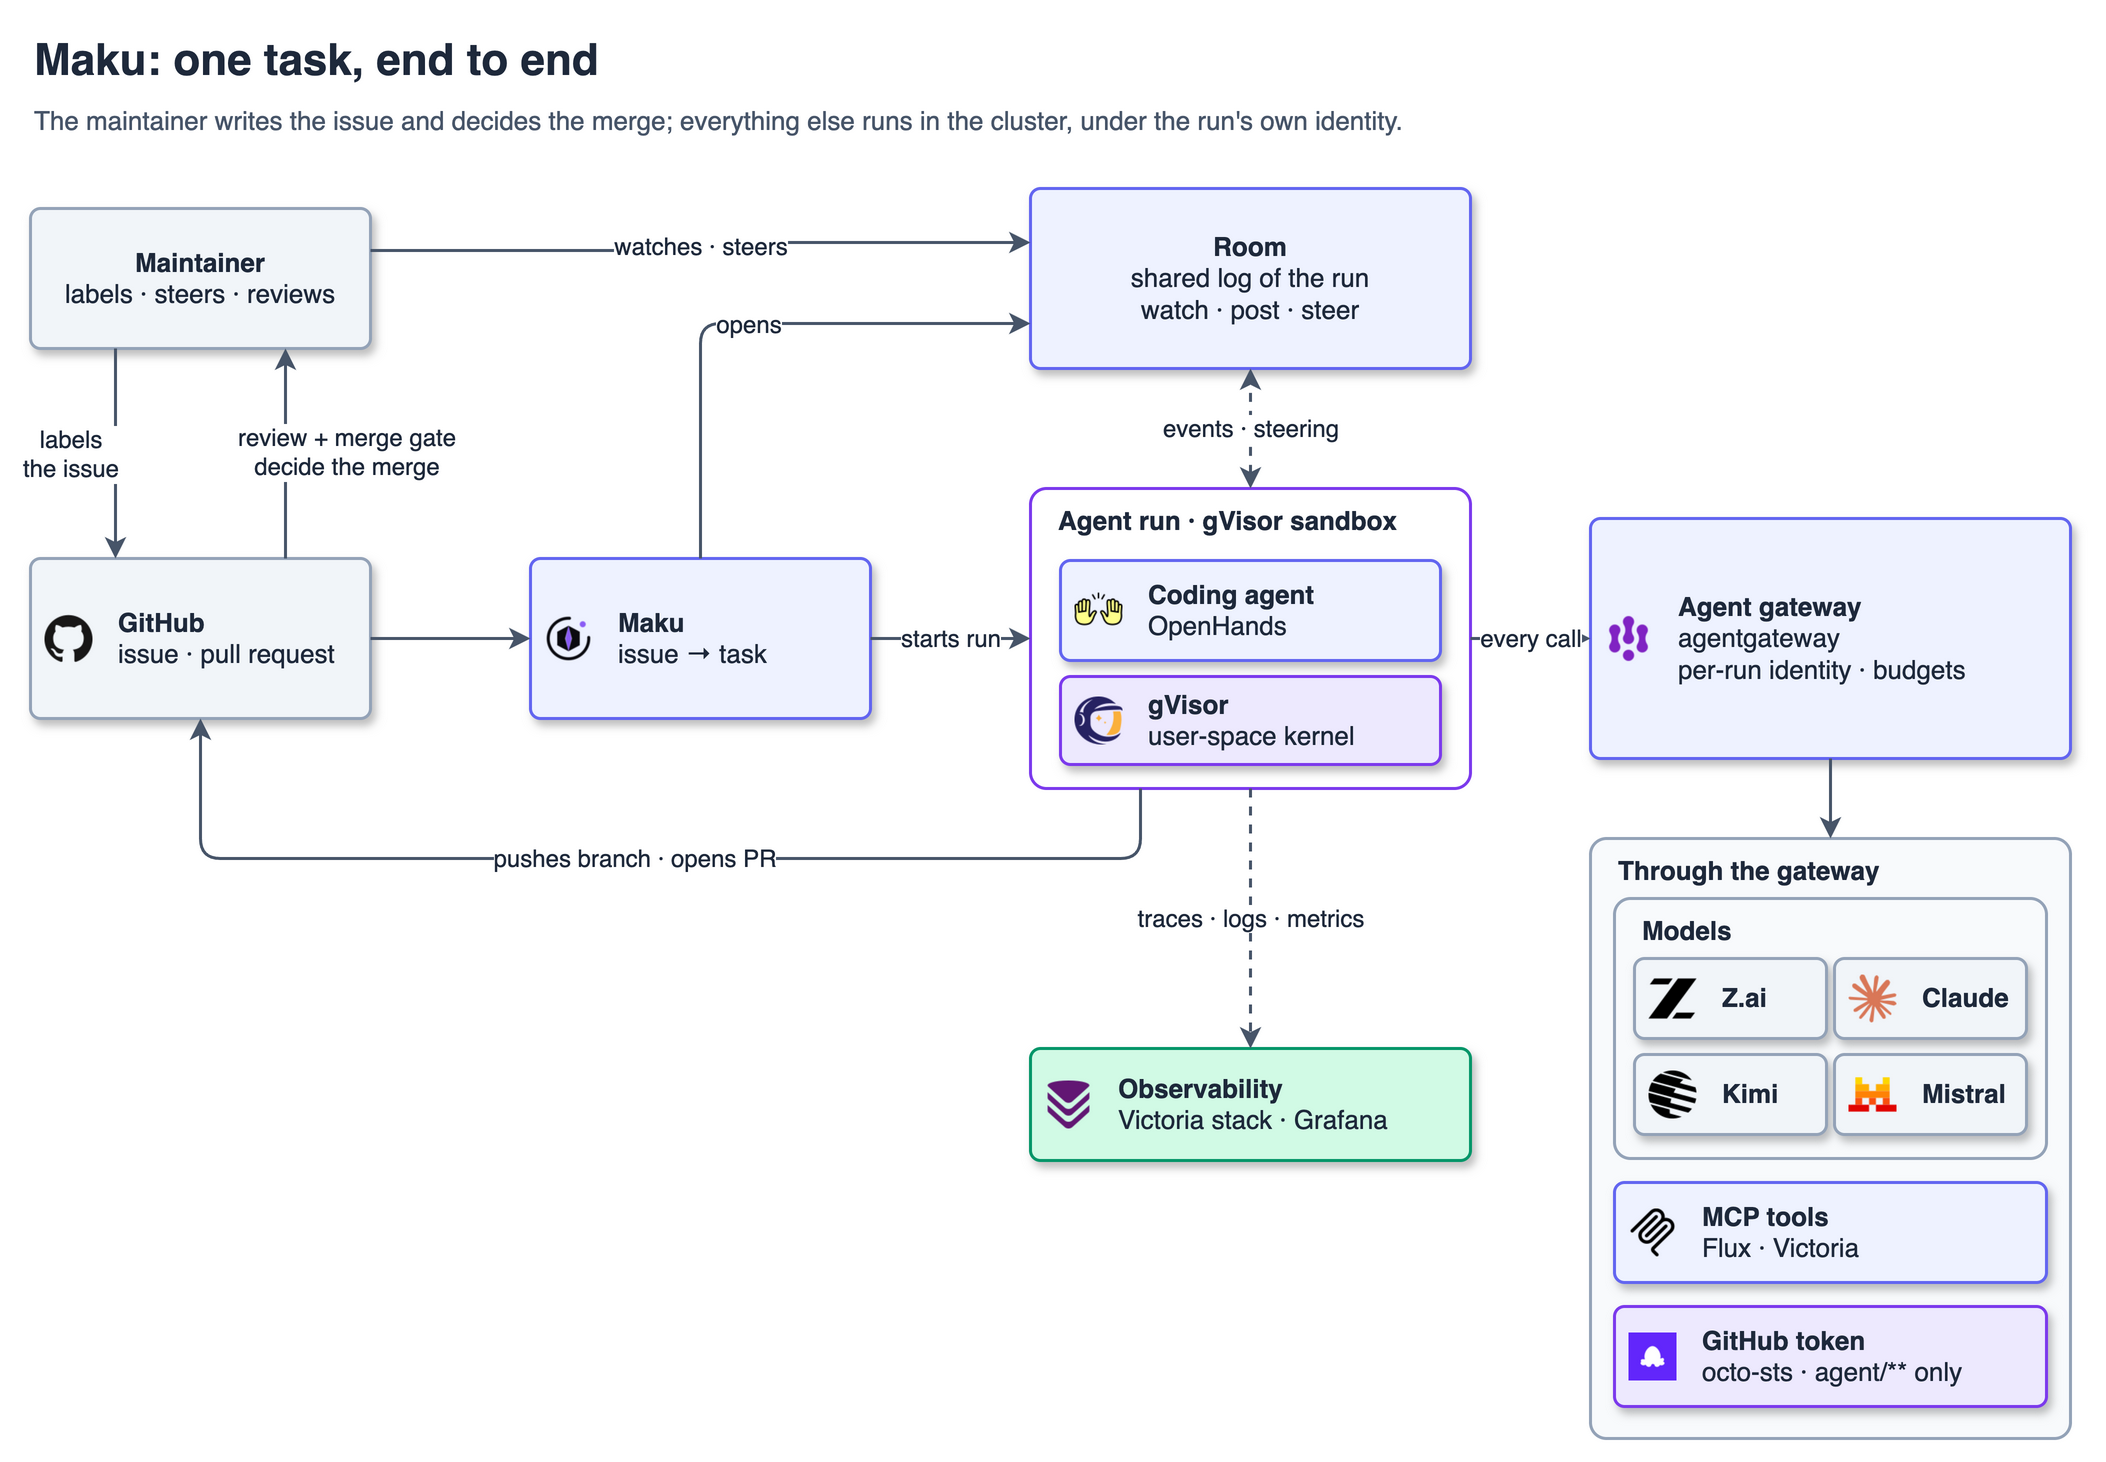
Un mainteneur pose le label
factory/readysur une issue. Le même label posé par quelqu'un d'autre ne déclenche rien. Une tâche peut aussi partir de Slack, de la CLImakuou directement de votre coding agent.Maku crée une tâche et une room, le journal partagé de cette tâche. Il choisit un budget (modèle, tokens, durée maximale), puis lance les agents.
Chaque agent tourne dans sa propre sandbox, sous sa propre identité. Tout ce qu'il appelle (modèle, outil, GitHub) passe par l'agent gateway.
Les agents se relaient : l'un cadre la tâche, un autre écrit le changement et ouvre la PR, un juge vérifie que c'est terminé, un reviewer relit avec un regard neuf.
Le merge gate décide : merge sans humain pour les rares changements qui ont gagné ce droit, sinon une seule action vous revient, et votre approbation du commit vaut merge.
💭 Dernières remarques
Pour un projet de quelques semaines, les premiers résultats sont bluffants ! Il faut dire que je partais d'un socle cloud native déjà bien éprouvé 😉. Jusqu'ici, je m'étais surtout évertué à obtenir une configuration locale efficace avec Claude Code ou OpenCode, et à suivre l'évolution ultra dynamique des modèles. Les besoins en entreprise m'ont amené à regarder de plus près les problématiques d'organisation : donner de l'autonomie et de la puissance, tout en conservant le contrôle.
Cette software factory m'a d'abord servi à explorer plein de sujets, mais je me suis pris au jeu et le résultat devient de plus en plus sérieux. La prochaine étape, déjà sur la feuille de route, le prouve : elle s'appelle « anyone can run it », et c'est un sacré challenge que je raconterai dans les aventures à venir.
Le prochain article parlera de Maku, la couche qui orchestre tout ce beau monde. En voici un aperçu :
🔖 Références
Dépôts, docs et démo
ai-native-ref: la plateforme IA · documentation · état et feuille de routemaku: le contrôleur · démo publique d'une roomcloud-native-ref: le cluster hôte · documentation
Software factories
- Addy Osmani : Software Factories, Light and Dark
- InfoQ : les Minions, les agents autonomes de Stripe
- Spotify Engineering : 1,500+ PRs Later, Honk Part 1
- Dan Shapiro : The five levels, from spicy autocomplete to the software factory
- Simon Willison : la software factory de StrongDM
- Agent Baseline : The Secure Software Factory, architecture de référence
- awesome-software-factories : le paysage, régulièrement mis à jour